AI 工具與方案 / 數據更新至 2026 年 10 月
把一份 50 頁的合約丟給 AI,前幾輪它答得頭頭是道;聊到第 20 輪,它卻忘了你一開始交代的格式,甚至把第 3 頁的條款講錯。這多半不是 AI 變笨,而是它的上下文滿了。
上下文決定 AI 一次能讀多少資料、一段對話能撐多久,是做文書處理時最常被忽略的規格。2026 年 10 月,Claude、GPT、Gemini 的旗艦模型在開發者介面(API)上都來到約 100 萬 tokens,但你在 App 裡實際拿到的數字,可能只有它的二十分之一。這篇整理四件事:上下文到底是什麼、各大模型差多少、排行榜上誰的長文件與文書能力最好,以及做文書工作該選哪一個。
※ 本文的上下文單位統一用「萬 tokens」:100 萬=1M、12.8 萬=128K、5.4 萬=54K。
30 秒看重點
約 100 萬
Claude Opus 5.5、GPT-6.1、Gemini 4 Argon 的 API 上下文都在這個量級
5.4 萬
ChatGPT Plus 一般模式(Instant)的總上下文;切到推理模式是 25.6 萬
100 萬
Claude 付費方案與 Google AI Pro,在 App 裡就能用到 100 萬 tokens
第 1 名
Claude Opus 5.5 在 GDPval-AA(文件、簡報、試算表等職場產出)與主流模型的長文件測驗都領先
97% → 37%
同一個模型在短對話幾乎全對,塞到上百萬 tokens 時找資料的成功率大幅下降
資料:Anthropic、OpenAI、Google、xAI 官方文件與方案頁,LMArena、Artificial Analysis 排行榜,查詢於 2026 年 10 月 27 日,詳見文末資料來源。
01上下文是 AI 的工作桌,不是它的書櫃
想像 AI 有兩樣家具。書櫃是它在訓練時讀過的大量資料,已經內化成知識;工作桌則是這一次對話攤開的東西:你的指示、上傳的檔案、你們來回的對話,以及它正在寫的回答。上下文(context window)指的就是這張工作桌的大小。Anthropic 的官方文件把它形容為模型的「工作記憶」,和訓練資料是兩回事。
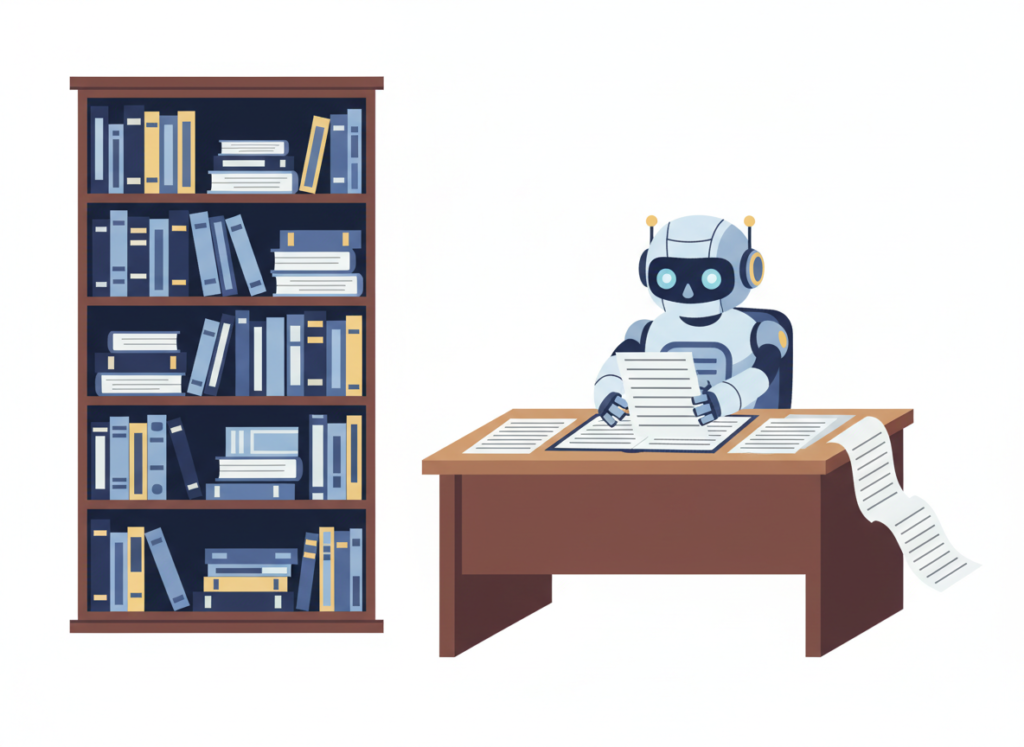
所以 AI 能回答「台灣的首都在哪」,靠的是書櫃;它能幫你整理「這份合約第 12 條在講什麼」,靠的是工作桌。桌子越大,一次能攤開的文件越多,對話也能拉得越長。
桌上會放哪些東西
很多人以為上下文只算自己打的字,其實系統指令、記憶、上傳的檔案、AI 的回答,推理模型「先想一想」的思考過程,全部都要佔位置。
Token 是什麼
上下文用 token 計算,它是 AI 切字的單位。英文大約 4 個字母算 1 個 token(Google、OpenAI 的估算),Anthropic 則說 Claude 新版切字器處理同樣的文字,token 數比舊版多約 30%。中文沒有統一換算,常見估算是 1 個字約 1 到 2 個 token,會因模型而不同。所以官方多半用「頁數」說明:Google 說 100 萬 tokens 約 1,500 頁文字,Anthropic 說 20 萬 tokens 約 500 頁以上。想複習 token 的觀念,可以看〈生成式 AI 是什麼〉。
桌子滿了會怎樣
最早的內容被擠出去
AI 看不到對話開頭,於是忘了你交代的語氣、格式或規則。
舊內容被自動摘要
Claude 付費方案(開啟程式碼執行時)接近上限會摘要較早的訊息,對話能繼續,但細節會流失,也更耗額度。
直接提示對話太長
有些 App 會要求你開新對話,這時就得自己把重點帶過去。
02同一個模型,API 和 App 給的上下文不一樣
新聞裡看到的「100 萬 tokens」,通常是 API 的規格,也就是工程師把模型串進自己系統時能用的上限。一般人用的 ChatGPT、Claude、Gemini App,會再依訂閱方案另外設限。先看 API,也就是各家模型「最多能做到多少」:
| 模型(官方定位) | API 上下文 | 要注意的地方 |
|---|---|---|
| Claude Opus 5.5 複雜、需要仔細判斷的工作 | 100 萬 | 單次最多輸出 12.8 萬;100 萬是預設,不另外加價 |
| Claude Sonnet 5.5 日常工作、文件、簡報、試算表 | 100 萬 | 同上 |
| GPT-6.1 Sol 複雜工作與電腦操作 | 105 萬 | 輸入超過 27.2 萬,整筆請求輸入費 2 倍、輸出費 1.5 倍 |
| GPT-6.1 Terra 清楚自然的寫作、視覺推理 | 105 萬 | 同上;10 月下旬推出,價格較低 |
| Gemini 4 Argon Google 旗艦推理模型 | 約 105 萬 | 輸入、思考、輸出共用同一個額度;單次預設最多輸出約 6.6 萬 |
| Grok 4.7 程式、代理與知識工作 | 50 萬 | 約是其他旗艦的一半 |
資料:各家官方開發者文件(Anthropic、OpenAI、Google、xAI),查詢於 2026 年 10 月 27 日。精確數字:GPT 為 1,050,000、Gemini 為 1,048,576 tokens。
看數據,先看定義
同樣寫「100 萬」,意思不一定一樣。Gemini 4 Argon 的約 105 萬是輸入、思考與輸出加起來的總量;Claude 是上下文 100 萬、另外限制單次輸出 12.8 萬;ChatGPT 方案頁寫的則是「總上下文」,並註明你能輸入的部分比總量小,因為系統指令、記憶和推理也要空間。比較之前,先確認比的是同一件事。
03你在 App 裡實際拿到多少,差距比想像大
對多數上班族來說,真正重要的是 App 裡的數字。以下是各家官方方案頁與說明中心公布的上下文:
| 平台與方案 | 上下文(總量) | 官方估算可放入 |
|---|---|---|
| ChatGPT 免費 | 2.7 萬 | 約 12 頁 |
| ChatGPT Go/Plus 一般模式/推理模式 | 5.4 萬/25.6 萬 | 約 40 頁/約 320 頁 |
| ChatGPT Pro 一般模式/推理模式 | 12.8 萬/40 萬 | 約 250 頁/約 680 頁 |
| Claude 付費方案 Opus 5.5、Sonnet 5.5、Haiku 5.5、Fable 5.1 | 100 萬 | 20 萬約 500 頁以上 |
| Claude 付費方案 Opus 4.6–4.8、Sonnet 4.6 等舊模型 | 50 萬 | 其餘模型為 20 萬 |
| Gemini 免費 | 3.2 萬 | — |
| Google AI Plus | 12.8 萬 | — |
| Google AI Pro/Ultra | 100 萬 | 約 1,500 頁 |
| Grok App | 官方未公布 | — |
資料:ChatGPT 方案頁、Claude 說明中心、Gemini Apps 說明中心,查詢於 2026 年 10 月 27 日。頁數為各家以英文文字估算;ChatGPT 的頁數指「可輸入的上限」。
同樣是每月約 20 美元的個人方案,App 裡的上下文差多少?
以 100 萬 tokens 為滿格,比較各方案在 App 中的總上下文
ChatGPT Plus(一般模式)
ChatGPT Plus(推理模式)
Claude Pro(Sonnet 5.5/Opus 5.5)
Google AI Pro(Gemini 4 Argon)
※ ChatGPT Plus、Claude Pro、Google AI Pro 美國月費皆約 20 美元;方案內容以官網為準。
要記得
同一個 ChatGPT 帳號,一般聊天、推理模式和 ChatGPT Work 的上下文都不一樣:官方說明 GPT-6.1 Sol 在 ChatGPT Work 與 Codex 中預設是 50 萬。處理長文件時,記得把模型切到推理模式或 Work,不要用預設的一般模式硬塞。想知道 20 美元該訂哪一家,可以搭配〈US$20 怎麼選〉一起看。
04上下文越大越好嗎?裝得下,不等於記得住
上下文是桌子的大小,不代表 AI 會把桌上每張紙都看仔細。Anthropic 在官方文件裡直接寫明:token 越多,模型的準確度和回想能力會下降,這種現象叫 context rot(上下文腐化)。所以放進桌上的內容要挑過,不是越多越好。
塞得越滿,找得越準嗎?
OpenAI 公布的 GPT-5.4 測試:在對話中找出 8 個指定片段的成功率
對話長度約 0.4–0.8 萬 tokens
對話長度約 51–100 萬 tokens
資料:OpenAI〈Introducing GPT-5.4〉(2026 年 3 月),MRCR v2 8-needle 測試。※ 這是較早的模型,用來說明趨勢,新模型的數字可能不同。
除了漏看,長上下文還有三個代價:
越長越容易漏看
重要條款埋在第 200 頁時,AI 比較容易跳過或記錯。關鍵資料最好放在開頭或結尾,或直接告訴它要看哪一段。
越長越貴、越耗額度
OpenAI 的 API 輸入超過 27.2 萬 tokens 時整筆加價;Claude Haiku 5.5 超過 10 萬 tokens 費率較高;App 裡的長對話也會更快用完額度。
能用的空間比帳面小
系統指令、記憶、工具與推理都會佔位置。ChatGPT 官方就註明可輸入的部分小於總上下文。
實務上,與其一直在同一個對話裡追加文件,不如善用「專案」功能:Claude 官方說明,專案會用檢索(RAG)的方式只把相關內容載入上下文,比整包塞進去更省空間。省額度的其他技巧,整理在〈AI 額度省著用〉。
先看你的方案給多少桌面,再看模型多會寫。
——TempEDU 整理
05排行榜怎麼說:長文件與文書能力,誰最強
上下文規格只告訴你桌子多大,排行榜才看得出 AI 實際做得好不好。我們挑了三個和文書處理最相關、而且公開可查的榜單:
LMArena 文字競技場:大家覺得誰的回答比較好
使用者對同一個問題看兩個匿名模型的回答,投票選較好的,再換算成分數。代表一般人的整體偏好,題目多半是短對話。
GDPval-AA:做出來的文件能不能交差
Artificial Analysis 用 44 種職業的真實工作任務,讓模型實際產出文件、簡報、圖表與試算表,再由評審兩兩盲測比較。最接近「文書產出」的能力。
AA-LCR:讀完長文件後答得對不對
同樣由 Artificial Analysis 主辦,讓模型閱讀約 1 萬到 10 萬 tokens 的論文、財報、法律文件與產業報告,回答需要跨段落整合的問題,看正確率。
LMArena 文字榜
使用者盲測偏好(分數越高越好)
Gemini 4 Argon 全榜第 1、Opus 5.5 第 2。2026/10/22 更新;GPT-6.1 Terra 尚未上榜。
GDPval-AA
文件、簡報、試算表等職場產出(分數越高越好)
Claude Opus 5.5 為全榜第 1;分數有約 ±20 的誤差範圍。
AA-LCR
長文件推理正確率
全榜最高為 Kimi K3 的 88.7%;本表只列主流平台模型。
資料:LMArena 文字競技場(2026 年 10 月 22 日);Artificial Analysis GDPval-AA v2.1;AA-LCR 分數取自 BenchLM 整理的 Artificial Analysis 數據(2026 年 10 月 26 日)。
把三個榜單放在一起看,結論相當清楚:
| 模型 | 三個榜單的表現 | 最適合 |
|---|---|---|
| Claude Opus 5.5 | 文書產出第 1、主流模型長文件第 1、使用者偏好第 2 | 長文件與重要文書的首選 |
| Claude Sonnet 5.5 | 文書產出只比 Opus 少 28 分,長文件 82.7% | 日常文書,速度快、費用低 |
| GPT-6.1 Sol/Terra | 長文件 83.0%/82.7% 表現好,文書產出分數偏低 | 長文件問答、摘要 |
| Gemini 4 Argon | 使用者偏好第 1,但長文件 79.7% 在主流中偏後 | 寫作語氣、Google 生態整合 |
| Grok 4.7 | 三個榜單都落後 | 不建議當主力文書工具 |
整理:TempEDU,依上方三個榜單,2026 年 10 月。
榜單多半測最強設定
排行榜通常用 API 和最高推理強度測試,App 預設模式與上下文較小,實際體驗可能比分數差。
差幾分不一定有差
AA-LCR 前段班差距只有幾個百分點,GDPval-AA 也有約 ±20 分的誤差,名次接近時當成同一級即可。
LMArena 偏短對話
LMArena 反映的是大眾對回答的整體喜好,不直接測長文件;判斷長文件能力,要看 AA-LCR 這類測驗。
06文書處理該選哪個模型:依工作情境來挑
文書處理其實是五種不同的工作:讀長文件做摘要、跨文件比對、撰寫報告與公文、改寫潤稿,以及把結果做成 Word、簡報或試算表檔案。前兩種最吃上下文,後三種更看重寫作能力和工具整合。依情境整理如下:
| 情境 | 建議 | 原因 |
|---|---|---|
| 一次讀上百頁 多份合約、標案、法規比對 | Claude Opus 5.5 次選:GPT-6.1 Sol(ChatGPT Pro 或 Work) | App 端 100 萬,AA-LCR 主流最高 84.7%;GPT-6.1 Sol 有 83.0%,但 Plus 推理模式只有 25.6 萬 |
| 日常寫報告、做檔案 文件、簡報、試算表 | Claude Sonnet 5.5 | GDPval-AA 1838 分,接近 Opus;Anthropic 說它擅長產出完成度高的文件、簡報與試算表 |
| 文字要自然、在 Office 裡用 信件、公告、潤稿 | ChatGPT(Plus 以上,長文件切推理模式) | Plus 起可用 Word、Excel、PowerPoint 外掛;GPT-6.1 Terra 官方定位是清楚自然的寫作 |
| 公司全用 Google Gmail、文件、試算表 | Gemini(Google AI Pro) | LMArena 文字榜第 1,回答最受使用者青睞;可直接在 Gmail、文件、試算表裡使用 |
| 要結合即時話題 社群、新聞整理 | Grok 4.7 | 可搜尋 X 即時內容,但三個榜單都落後,正式文書與長文件不建議 |
整理:TempEDU,依各家官方定位、2026 年 10 月方案規格與上述排行榜。實際表現仍會因文件內容與提示詞而不同。
免費版怎麼辦
ChatGPT 免費版約 2.7 萬、Gemini 免費版 3.2 萬 tokens,大約只放得下十幾頁。處理長文件時,可以先用 NotebookLM 這類以「來源」為主的工具做查找與摘要,再把整理好的重點交給聊天型 AI 寫成文件。
如果你的文書工作最後要變成簡報,上下文大的模型能一次讀完整份報告再規劃頁面,效果會好很多。各家 AI 做簡報的實測比較,可以看〈AI 簡報教學:ChatGPT、Canva、Gamma 做 PPT 實測比較〉與〈Claude Slides 實作教學〉;行政工作的完整應用,則整理在〈行政人員如何使用 AI〉和〈用 AI 自動完成 Excel 報表〉。
這些數字不是絕對的
方案常常調整
2026 年各家幾乎每個月都在改模型與方案,本文數字以 10 月 27 日的官方頁面為準,使用前請再確認。
頁數是英文估算
官方頁數多以英文文字計算;中文、表格、圖片與掃描 PDF 的換算都不同,實際能放的量可能更少。
地區與帳號不同
Gemini 4 Argon 在 Google AI Pro 是分國家陸續開放;企業與教育方案的上下文另有規定。
總量包含回答
上下文是輸入加輸出的總量,要 AI 寫長報告時,留給輸入文件的空間會變少。
07三個步驟,選對你的文書 AI
先估文件量
把這次要處理的文件頁數加起來。超過 40 頁,就別用 ChatGPT Plus 的一般模式。
選對模式或方案
長文件用推理模式,或選擇 App 端有 100 萬的 Claude 付費方案、Google AI Pro。
用專案管理文件
把常用參考資料放進專案或 NotebookLM;長對話定期開新對話,附上前一段的摘要。
行政人員
公文、會議紀錄、報表的格式規則寫在專案指示裡,不用每次重講,也不怕被長對話擠掉。
老師
整學期的講義與題庫可以一次交給 100 萬上下文的模型比對,找出重複或缺漏的單元。
企業主管
選團隊方案時,除了價格也比較上下文;常處理合約與標案的部門,上下文比回答速度更重要。
延伸學習
選好模型之後,下一步是把文件真正做出來。這三門 TempEDU 課程可以接著學:
也可以搭配閱讀這些文書相關文章:
本文重點
- 上下文是 AI 這次對話的工作桌,裝的是指示、檔案、對話、思考與回答,不是它學過的知識。
- API 上,Claude Opus 5.5、GPT-6.1、Gemini 4 Argon 都約 100 萬 tokens,Grok 4.7 為 50 萬。
- App 裡差距更大:ChatGPT Plus 一般模式 5.4 萬、推理 25.6 萬;Claude 付費方案與 Google AI Pro 為 100 萬。
- 排行榜上,Claude Opus 5.5 在文書產出(GDPval-AA)與主流模型長文件(AA-LCR)都第 1;Gemini 4 Argon 是 LMArena 使用者偏好第 1。
- 裝得下不等於記得住,上下文越長越容易漏看、越耗額度,重要資料要挑過再放。
- 做文書:長文件比對首選 Claude Opus 5.5,日常產出文件選 Claude Sonnet 5.5,重視 Office 整合選 ChatGPT,Google 生態選 Gemini。
想一想
你最常交給 AI 的文件,一次大概有幾頁?如果它只能看其中 40 頁,你會怎麼挑選、怎麼排順序,讓它把最重要的部分看清楚?
資料來源
- Anthropic(2026 年 10 月查詢)。Context windows(Claude Platform Docs)
- Anthropic 說明中心(2026 年 10 月查詢)。How large is the context window on paid Claude plans?
- OpenAI(2026 年 10 月查詢)。ChatGPT Plans and Pricing
- OpenAI 說明中心(2026 年 10 月查詢)。Models in Work and Codex
- OpenAI(2026 年 10 月查詢)。GPT-6.1 Sol Model
- OpenAI(2026 年 10 月查詢)。GPT-6.1 Terra Model
- OpenAI(2026 年 3 月 5 日)。Introducing GPT-5.4
- Google(2026 年 10 月查詢)。Gemini 4 Argon(Gemini API)
- Google 說明中心(2026 年 10 月查詢)。Gemini Apps limits & feature availability
- Google(2026 年 10 月 13 日)。Gemini 4 Argon comes to the Gemini app
- xAI(2026 年 10 月查詢)。Grok 4.7 Developer Guide
- LMArena(2026 年 10 月 22 日更新)。Text Arena Leaderboard
- Artificial Analysis(2026 年 10 月查詢)。GDPval-AA Leaderboard
- Artificial Analysis(2026 年 10 月查詢)。AA-LCR Long Context Reasoning
- BenchLM(2026 年 10 月 26 日)。AA-LCR Leaderboard & Scores
- 9to5Mac(2026 年 9 月 28 日)。Anthropic upgrades Claude with new Sonnet 5.5 model
本文插圖為 AI 生成的示意圖。
Edit with Tr.Bug
Follow me on:LinkedIn | 探教育TempEDU