AI 工具與方案 / 資料更新至 2026 年 11 月
做一支有旁白、有配樂、有畫面、還有字幕的短片,過去要訂閱四、五個雲端服務。到了 2026 年下半年,這些環節幾乎都有能下載回自己電腦跑的開源模型,而且品質追到商用服務的門口。
網路上流傳一份「想玩一整套就裝這些」的清單:語音辨識 QwenASR 加 Whisper、語音合成 IndexTTS 加 BreezyTTS、音樂 YuE2 加 MiniMax Music、影像 QwenImage 2.1、大模型 Qwen3.8 27B、影片 MiniMax H3 加 LTX 2.5。這篇逐一查證每個模型:它是誰做的、能做什麼、電腦要多強,以及最容易被忽略的一件事——能不能拿來賺錢。
30 秒看重點
6 類 10 個
語音辨識、語音合成、音樂、影像、大語言模型、影片,每類都有能下載的權重。
4 個最寬鬆
Qwen3-ASR、Whisper、BreezyVoice、Qwen3.8-27B 用 Apache 2.0 或 MIT,可以商用。
2 個不能商用
YuE2 與 Qwen-Image-2.1 的權重限非商業使用,接案、做產品要避開或另談授權。
約 6 GB 起
IndexTTS-2.5 這類語音模型一般顯示卡就能跑;影片模型官方建議 32 GB 以上。
24 GB
一張 24 GB 顯示卡(RTX 3090/4090 等級)能跑起這套組合的大部分模型。
資料:各模型官方頁面與授權文件,查證至 2026 年 11 月,詳見文末資料來源。
00先看全貌:十個模型怎麼分工
這份清單的邏輯很像一間小型製作公司:大語言模型當編劇,負責寫腳本和各種提示詞;語音、音樂、影像三組人分頭做素材;影片模型負責合成;最後用語音辨識把對白轉成字幕。
| 類別 | 清單裡的模型 | 一句話用途 |
|---|---|---|
| 語音辨識 ASR,聲音轉文字 | Qwen3-ASR、Whisper | 會議記錄、影片字幕、語音輸入 |
| 語音合成 TTS,文字轉聲音 | IndexTTS、BreezyVoice | 旁白配音、有聲書、聲音複製 |
| 音樂 歌詞與風格轉歌曲 | YuE2、MiniMax Music 3 | 有人聲的完整歌曲、配樂 |
| 影像 生圖與修圖 | Qwen-Image-2.1 | 生圖、多圖合成、透明背景素材 |
| 大語言模型 LLM | Qwen3.8-27B | 寫腳本、看圖看影片、當 AI 助理 |
| 影片 含同步聲音 | MiniMax H3、LTX-2.5 | 文字或圖片生成短片,連聲音一起出 |
整理:TempEDU,2026 年 11 月。
名稱對照
清單裡的 BreezyTTS,正式名稱是聯發創新基地的 BreezyVoice;MiniMax Music 指的是 2026 年 8 月開放權重的 MiniMax Music 3;QwenASR 是 Qwen3-ASR。搜尋或下載時用正式名稱,比較不會找到山寨版本。
01語音辨識:Qwen3-ASR 拚準度,Whisper 拚生態
Qwen3-ASR 是阿里巴巴通義千問團隊在 2026 年 1 月 29 日釋出的語音辨識模型,有 1.7B 和 0.6B 兩個尺寸,支援 30 種語言加 22 種中文方言(含閩南語),授權是 Apache 2.0。官方說 1.7B 版在開源模型中準度領先、可和商用 API 一較高下;0.6B 版走效率路線,在 128 路同時處理時,1 秒能轉完約 2,000 秒的語音。另外附一個時間軸對齊模型,做字幕時可以把每個字對到正確秒數。
Whisper 是 OpenAI 的老牌語音辨識模型,最新的 large-v3 支援 99 種語言、MIT 授權。它的優勢不是最準,而是周邊工具最多:whisper.cpp、faster-whisper、各種字幕軟體與語音輸入 App 都以它為基礎,Mac 和 Windows 都找得到現成的安裝包。
| Qwen3-ASR | 1.7B/0.6B ・ 52 種語言與方言 ・ Apache 2.0 ・ 2026 年 1 月 |
| Whisper large-v3 | 約 15.5 億參數 ・ 99 種語言 ・ MIT ・ 周邊工具最完整 |
| 台灣補充 | Breeze-ASR-25:聯發創新基地以 Whisper 微調,強化台灣口音與中英夾雜 ・ Apache 2.0 |
台灣使用者要記得
Qwen3-ASR 與 Whisper 輸出中文時常偏向簡體字,做字幕前記得用 OpenCC 一類的工具轉成台灣繁體(例如「視頻」改「影片」)。如果錄音裡常中英夾雜,例如「放進你的 training 裡面」,可以加試聯發創新基地的 Breeze-ASR-25;他們 2026 年也釋出了台語辨識模型 Breeze-ASR-26。
02語音合成:IndexTTS 會演戲,BreezyVoice 會念破音字
IndexTTS 來自中國影音平台 bilibili 的 Index 團隊。2025 年 9 月的 IndexTTS-2 主打兩件事:能精準控制每句話念多長(對嘴型、配字幕很重要),以及把「音色」和「情緒」分開控制——同一個聲音,可以指定開心、難過或生氣。2026 年 8 月 10 日推出的 IndexTTS-2.5 再加上日文、西班牙文、阿拉伯文,推論速度約為前代的 2 倍以上,官方說大約 6 GB 顯示記憶體就能跑。
BreezyVoice 是聯發創新基地與台大合作、專為台灣華語調校的語音合成模型,以 CosyVoice 為基礎。它最實用的設計是可以在文字裡直接加注音,解決「銀行」的「行」、「重新」的「重」這類破音字念錯的老問題,中英夾雜的句子也念得自然。權重採 Apache 2.0 授權。
適合
- IndexTTS:有情緒、要對嘴型秒數的旁白與動畫配音
- IndexTTS-2.5:需要日文或西文等多語配音
- BreezyVoice:台灣口音、破音字多、中英夾雜的教學旁白
要注意
- IndexTTS 採 bilibili 模型使用授權,官方頁未列商用條件,商用前要先洽詢
- 兩者都能用幾秒鐘的錄音複製聲音,一定要取得聲音本人同意
- BreezyVoice 以台灣華語為主,不適合其他語言
03音樂:YuE2 能改譜,MiniMax Music 3 能商用
YuE2 由香港科技大學與 Multimodal Art Projection(M-A-P)社群開發,2026 年 9 月釋出 3B 版本。給它歌詞和一句風格描述,就能生成有人聲、有伴奏的完整歌曲,輸出 48 kHz 立體聲。它跟其他音樂模型最大的不同,是會先寫出一份可編輯的樂譜(ABC 格式):覺得某個和弦不對,改譜再重新生成,不用整首重抽。開發團隊在自家 WildSongBench 測試中表示,挑 8 首選最好的一首時,整體分數略高於 Suno v5。
MiniMax Music 3 是中國 AI 公司 MiniMax 在 2026 年 8 月 13 日開放權重的音樂模型,同樣用歌詞加音樂描述生成歌曲,最長約 5 分鐘、32 kHz 立體聲。官方說完整精度在 24 GB 顯示記憶體以內,開啟逐層載入的話 8 GB 顯示卡也能跑,只是比較慢;ComfyUI 有原生支援。
| 項目 | YuE2-3B | MiniMax Music 3 |
|---|---|---|
| 拿手 | 可改樂譜、翻唱、改編 | 長度、結構完整的歌曲 |
| 授權 | CC BY-NC 4.0,不可商用 | 社群授權,可商用但有條件 |
| 硬體 | 官方建議 24 GB 顯示卡 | 24 GB 以內,8 GB 可慢速跑 |
資料:兩個模型的 Hugging Face 官方頁面與授權檔,2026 年 11 月查證。
看授權,要看原始檔
有些媒體報導 MiniMax Music 3 是 CC BY-NC 4.0(不可商用),但模型庫裡的官方授權檔寫的是「MiniMax-Music3 社群授權」:可以商用,條件是在產品介面明顯標示 MiniMax-Music3,年營收超過 2,000 萬美元要先取得書面授權。二手報導會出錯,下載前直接打開 LICENSE 檔最準。
04影像:Qwen-Image-2.1 把生圖、修圖、去背合成一個
Qwen-Image-2.1 在 2026 年 9 月 20 日釋出,生成核心是 7B 參數,比初代 Qwen-Image 的約 20B 小很多。它把文字生圖和圖片編輯放進同一個模型,最多可以同時參考 10 張圖(例如把六個人的大頭照合成一張團體照),還能直接輸出帶透明背景的 PNG,做貼圖、商品去背、簡報素材都很方便。
官方在自家 Qwen-Image-Bench 評測中拿到 60.28 分,表示略高於 Google 的 Nano Banana 2.0;不過這是開發團隊自己設計的測驗,參考就好。官方頁沒有列出顯示記憶體需求,但提供把部分模型暫放到系統記憶體的省記憶體模式。
最大的坑:這版不能商用
初代 Qwen-Image 和 Qwen-Image-2512 都是 Apache 2.0,可以商用;2.1 改成 Qwen Research License,限非商業使用。台灣科技媒體報導,官方說明生成的圖片權利歸使用者,但模型本身不能在未取得授權下用於商業產品。要接案或做產品,可以改用 Apache 2.0 的 Qwen-Image-2512,或先向阿里巴巴申請授權。
05大語言模型:Qwen3.8-27B 是整套的編劇
Qwen3.8-27B 在 2026 年 8 月中開放權重,採 Apache 2.0 授權,是 27B 參數的稠密模型。它不只會寫字,還能看圖、看影片,原生支援 262,144 個 token 的上下文(約可一次讀進一本書),也能調整思考深度。官方評測中,它在程式與代理任務上明顯超越上一代 Qwen3.6-27B。
在這套全家桶裡,它的角色是編劇和總管:把一個主題拆成旁白稿、歌詞、生圖提示詞和鏡頭表,再交給其他模型。下面這段提示詞可以直接貼給它(或任何你常用的 AI)試試看:
跑得動嗎
量化成 4-bit 之後檔案約 17–19 GB,一張 24 GB 顯示卡(RTX 3090、4090)或 24 GB 以上統一記憶體的 Mac 就能跑;完整精度則需要 80 GB 等級的資料中心顯示卡。用 Ollama、LM Studio 都能一鍵下載。
06影片:MiniMax H3 最強但最重,LTX-2.5 最好上手
MiniMax H3 是海螺(Hailuo)影片系列的最新一代,2026 年 8 月 3 日開放權重。它是 33B 參數的模型,能同時理解文字、圖片、影片與聲音,一次生成最長 15 秒、24 fps、附立體聲的影片,支援 11 種語言的對白。第三方評測機構 Artificial Analysis 把它的影片編輯能力排在第一。
但開源版有三個限制:開放的只有核心模型,畫質上限 768p,2K 重製模組只在官方 API 提供;官方參考部署用 4 張 GPU,下載量至少 42.5 GB;授權排除美國、歐盟、英國、南韓的本地部署(台灣不在排除名單),年營收超過 2,000 萬美元要另取授權,產品介面也要標示 MiniMax H3。
LTX-2.5 來自以色列 Lightricks 分拆出的 LTX,2026 年 8 月 11 日釋出,22B 參數,影片和聲音一起生成,支援多鏡頭連續敘事與文字、圖片、影片、聲音轉影片等模式。官方的展示數據是在兩張 NVIDIA GB200 上,10 秒 720p 影片 6.8 秒生成完畢。授權對小團隊很友善:年營收未滿 1,000 萬美元,商用免費。
| 項目 | MiniMax H3 | LTX-2.5 |
|---|---|---|
| 強項 | 影片編輯、多素材參考、多語對白 | 速度快、多鏡頭、生態成熟 |
| 開源版畫質 | 768p,最長 15 秒 | 官方宣稱支援 4K HDR |
| 硬體 | 官方參考部署 4 張 GPU | 官方最低 32 GB,社群量化版約 16 GB 起 |
| 商用 | 年營收 2,000 萬美元以下可用,需標示 | 年營收未滿 1,000 萬美元免費 |
資料:MiniMax、LTX 官方頁面與授權文件,2026 年 11 月查證。
07但,開源不等於免費商用
「開源」這兩個字在 AI 模型上常被寬鬆使用。比較精確的說法是「開放權重」:你可以下載,但能不能拿來賺錢、能在哪裡用、要不要標示,全看授權條款。把這十個模型的授權攤開來看,差異比想像中大:
| 模型 | 授權 | 能不能商用 |
|---|---|---|
| Qwen3-ASR | Apache 2.0 | 可以 |
| Whisper | MIT | 可以 |
| IndexTTS-2/2.5 | bilibili 模型使用授權 | 需先洽詢 |
| BreezyVoice | Apache 2.0 | 可以 |
| YuE2 | CC BY-NC 4.0 | 不可以 |
| MiniMax Music 3 | MiniMax-Music3 社群授權 | 可以,有條件 |
| Qwen-Image-2.1 | Qwen Research License | 不可以 |
| Qwen3.8-27B | Apache 2.0 | 可以 |
| MiniMax H3 | MiniMax H3 社群授權 | 可以,有條件 |
| LTX-2.5 | LTX-2 社群授權 | 小公司可以 |
整理自各模型官方授權檔,2026 年 11 月。「有條件」指需標示模型名稱、超過營收門檻要另取授權等。本表不是法律意見。
下載得到,不代表用得起;用得起,也不代表能拿去賺錢。
授權會改
Qwen-Image 從 Apache 2.0 改成研究授權就是例子。每次更新版本,都要重看一次 LICENSE 檔。
評測多是自評
YuE2、Qwen-Image-2.1、Qwen3-ASR 的領先數據,多來自開發團隊自己的測驗,實際效果要用自己的素材試。
硬體數字看設定
同一個模型,完整精度和 4-bit 量化可以差到好幾倍;官方最低需求和社群回報也常不一致。
中文不一定好
很多模型的中文以簡體與中國口音為主,台灣用語、繁體字與破音字要特別測試。
08你的電腦跑得動哪幾個?
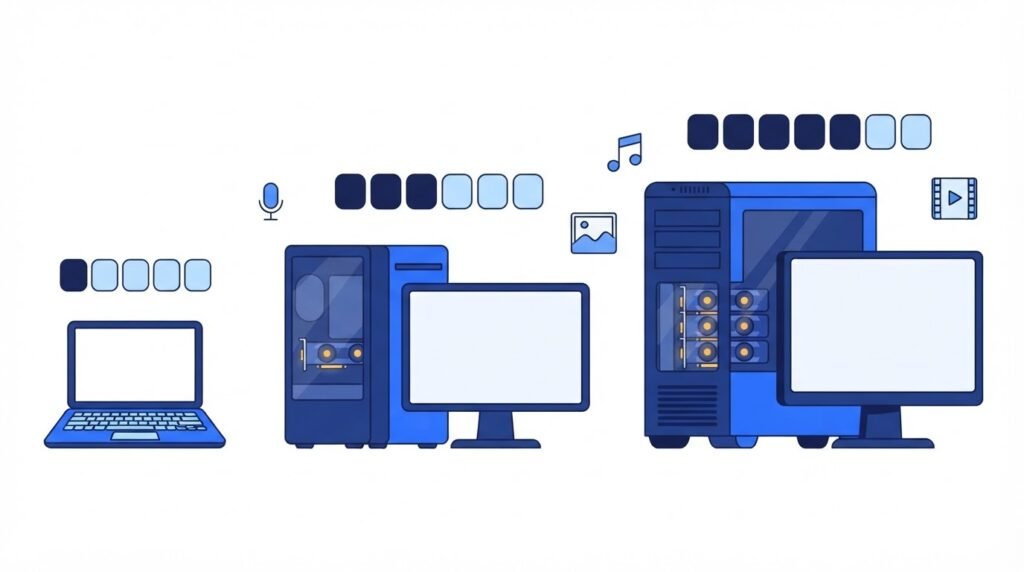
入門:約 6–12 GB
Qwen3-ASR、Whisper、Breeze-ASR-25 等語音辨識;IndexTTS-2.5(約 6 GB);MiniMax Music 3 的逐層載入模式(8 GB,慢)。
主力:24 GB
Qwen3.8-27B 4-bit、YuE2、MiniMax Music 3 完整精度、LTX-2.5 量化版。RTX 3090/4090 等級。
進階:32 GB 以上或多卡
LTX-2.5 官方設定(最低 32 GB,建議 80 GB)、MiniMax H3(官方參考部署 4 張 GPU)。
沒有高階顯示卡也不用急著買:可以先租雲端 GPU 按小時計費,或用 Colab 一類的服務試跑,確定哪幾個模型真的會常用,再決定要不要投資硬體。這十個模型中,多數在 ComfyUI 有官方或社群節點,可以用拖拉方塊的方式把整條流程串起來。
09想開始玩,三個步驟
先選一個用途
不要一次裝十個。先挑最常做的事,例如幫課程影片上字幕,就從語音辨識開始。
從小模型試起
Qwen3-ASR-0.6B、IndexTTS-2.5 這類幾 GB 的模型,一般電腦就能跑,先熟悉安裝流程。
確認授權再上線
要用在接案、課程販售或公司產品前,打開每個模型的 LICENSE 檔逐條確認。
對學生來說,這是理解 AI 各個環節最便宜的實驗室;對老師和創作者,是把課程影片、教材配音、宣傳短片自己做起來的機會;對企業,資料不出公司就能處理會議錄音與內部影音,但授權與資安更要先盤點清楚。
本文重點
- 這套全家桶涵蓋語音辨識、語音合成、音樂、影像、大語言模型與影片六類,共 10 個開放權重模型。
- 台灣使用者可加上聯發創新基地的 Breeze-ASR-25 與 BreezyVoice,處理台灣口音、中英夾雜與破音字。
- YuE2 與 Qwen-Image-2.1 不能商用;MiniMax 與 LTX 的模型有營收門檻與標示要求。
- 一張 24 GB 顯示卡能跑大部分模型,影片模型則建議 32 GB 以上或改租雲端 GPU。
- 授權與評測數據都要回到官方原始檔確認,二手報導常有出入。
想一想
如果你只能在電腦裡裝其中三個模型,你會選哪三個?它們能幫你省下哪一段最花時間的工作?
資料來源
- Qwen 團隊(2026 年 1 月)。Qwen3-ASR GitHub
- Qwen 團隊。Qwen3-ASR-1.7B 模型頁
- OpenAI。Whisper GitHub
- 聯發創新基地。Breeze-ASR-25 模型頁
- bilibili Index 團隊。IndexTTS GitHub(含 IndexTTS-2.5 更新)
- 聯發創新基地、台灣大學(2025 年 1 月)。BreezyVoice 論文
- 聯發創新基地。BreezyVoice 模型頁
- M-A-P。YuE2-3B 模型頁
- MiniMax(2026 年 8 月)。MiniMax-Music3 授權檔
- Qwen 團隊(2026 年 9 月)。Qwen-Image-2.1 模型頁
- 科技新報(2026 年 9 月 24 日)。Qwen Image 2.1 報導
- Qwen 團隊(2026 年 8 月)。Qwen3.8-27B 模型頁
- Unsloth。Qwen3.8 本機執行指南
- MiniMax(2026 年 8 月)。MiniMax H3 開源公告
- ComfyUI Wiki。MiniMax H3 模型介紹
- ComfyUI Wiki。LTX-2.5 模型介紹
- LTX。LTX-2.5 系統需求
- LTX。LTX 授權說明
本文插圖為 AI 生成的示意圖;授權整理僅供參考,不構成法律意見,商用前請以官方授權全文為準。
Edit with Tr.Bug
Follow me on:LinkedIn | 探教育TempEDU

2 Comments.
Comments are closed.